Все
 Истории
 Дизайн
 Код
 Геймдев
 Бизнес
 Маркетинг
 Управление
 Кино
 Музыка
 Проектная фотография
 Развитие
 Здоровье
 Деньги
 Образование
 EdTech
 Корп. обучение
 Блог Skillbox
 Глоссарий
 Спецпроекты
 Профориентация

ClickHouse: что это за СУБД, как она устроена и для чего нужна
Изучаем СУБД и замеряем производительность.
Представьте, что вы аналитик и вам надо посчитать выручку по всем регионам за год, а в таблице заказов миллиард строк. В PostgreSQL после отправки запроса СУБД задумается, а вы со спокойной совестью сможете пойти заваривать кофе. С ClickHouse таких кофе-брейков не будет — ответ придёт за секунды.
В этой статье мы разберём, чем ClickHouse отличается от обычных баз, как устроено колоночное хранение и почему оно такое быстрое. Вы узнаете, где применяют ClickHouse, какие у неё плюсы и минусы и когда стоит брать ClickHouse, а когда лучше остаться на PostgreSQL или MySQL.
Содержание
- Что такое ClickHouse
- Как появилась ClickHouse
- Отличия от PostgreSQL и MySQL
- Создаём тестовую базу данных
- Как устроено колоночное хранение
- Архитектура: движки, парты и ключ сортировки
- ClickHouse на практике: считаем метрики интернет-магазина
- Где применяют ClickHouse
- Плюсы и минусы ClickHouse
- ClickHouse против конкурентов
Что такое ClickHouse
ClickHouse — это система управления базами данных, ориентированная на аналитические задачи. В отличие от классических строковых СУБД, она хранит данные по столбцам. Благодаря этому ClickHouse может быстро обрабатывать большие объёмы данных, особенно когда запросу нужны только несколько столбцов из таблицы.
Обычно ClickHouse используют в качестве аналитического хранилища. Система хорошо подходит для запросов, в которых нужно обработать миллионы или даже миллиарды строк: посчитать события за определённый период, сгруппировать пользователей по странам, построить отчёт по продажам, найти аномалии в логах или рассчитать продуктовые метрики.
При этом ClickHouse хуже подходит для задач, где нужны частые точечные изменения отдельных записей, сложные транзакции или постоянное чтение одной строки по ключу. Например, хранить в ней состояние корзины интернет-магазина или данные личного кабинета обычно не стоит. С такой нагрузкой лучше справляются транзакционные СУБД вроде PostgreSQL и MySQL.
Скриншот: PowerShell Windows 10 / Skillbox Media
Как появилась ClickHouse
ClickHouse появилась внутри «Яндекса». Разработку начали в 2009 году для «Яндекс Метрики»: сервису надо было в реальном времени анализировать постоянно растущий поток данных о действиях пользователей. В 2012 году ClickHouse начали использовать в продакшене, а к 2014 она стала основной технологией новой версии «Метрики».
В июне 2016 года «Яндекс» открыл исходный код ClickHouse под лицензией Apache 2.0. После этого СУБД начали использовать сторонние компании, а вокруг проекта сформировалось международное сообщество разработчиков.
В сентябре 2021 года команда проекта перешла в независимую американскую компанию ClickHouse Inc., зарегистрированную в Делавэре со штаб-квартирой в районе Сан-Франциско. После последнего раунда финансирования в 2025 году компанию оценили примерно в 15 миллиардов долларов.
Несмотря на происхождение проекта, сейчас ClickHouse Inc. — независимая американская компания. При этом сама СУБД остаётся открытой и распространяется под Apache 2.0, поэтому её можно бесплатно развернуть на собственных серверах. В России также доступны управляемые версии ClickHouse у локальных облачных провайдеров — например, Yandex Cloud, Selectel и MWS Cloud Platform.
Читайте также:
Отличия от PostgreSQL и MySQL
Главное отличие ClickHouse от PostgreSQL и MySQL — в задачах, под которые спроектированы эти СУБД. PostgreSQL и MySQL в первую очередь рассчитаны на OLTP-нагрузку — множество небольших операций с отдельными записями. Например, провести платёж, создать заказ, изменить его статус или получить данные конкретного пользователя.
ClickHouse ориентирован на OLAP-нагрузку — аналитические запросы, которые обрабатывают большие объёмы данных. Вместо поиска одной записи такой запрос может пройти по миллионам строк, чтобы посчитать сумму продаж за год, сгруппировать пользователей по странам или определить количество событий каждого типа.
Отсюда следует разница в устройстве СУБД. PostgreSQL и MySQL обычно хранят данные по строкам — значения одной записи находятся рядом, поэтому систему удобно использовать, когда нужно быстро прочитать или изменить запись целиком. ClickHouse хранит данные по столбцам. Если для отчёта нужны только дата, страна и сумма покупки из таблицы с десятками полей, СУБД может прочитать именно эти столбцы, а остальные не трогать.
Читайте также:
Различается и работа с записью данных. Для PostgreSQL и MySQL нормально постоянно добавлять и изменять отдельные строки. ClickHouse эффективнее работает, когда новые данные поступают крупными партиями.
Ещё одно важное различие — первичный ключ. В PostgreSQL и MySQL он гарантирует уникальность записи: две строки с одинаковым значением первичного ключа добавить нельзя. В ClickHouse первичный ключ сам по себе уникальности не обеспечивает. Он нужен прежде всего для того, чтобы СУБД могла быстрее определить, какие части данных читать при выполнении запроса, а какие можно пропустить.
Создаём тестовую базу данных
Чтобы дальше разбирать ClickHouse не только в теории, создадим небольшую тестовую базу интернет-магазина. На ней будем проверять сжатие, смотреть, сколько данных читает ClickHouse, сравнивать скорость запросов и разбирать работу ключа сортировки.
Повторить примеры можно на обычном ноутбуке. На Linux и macOS ClickHouse работает нативно, а на Windows понадобится WSL.
Сначала скачиваем ClickHouse и запускаем её в локальном режиме:
curl https://clickhouse.com/ | sh
./clickhouse local --path ~/ch-demo
Теперь создадим базу shop и таблицу events с событиями интернет-магазина. В ней будет шесть столбцов: дата и время события, идентификатор пользователя, тип события, страна и сумма покупки:
CREATE DATABASE IF NOT EXISTS shop;

CREATE TABLE shop.events
(
    event_date Date,
    event_time DateTime,
    user_id UInt32,
    event LowCardinality(String),
    country LowCardinality(String),
    revenue Decimal(10, 2)
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_date)
ORDER BY (event_date, country, user_id);
Две особенности этой таблицы пригодятся нам дальше. Тип LowCardinality (String) подходит для столбцов с небольшим количеством повторяющихся значений, а ORDER BY определяет порядок данных внутри таблицы.
Осталось наполнить таблицу данными. Сгенерируем их средствами самой ClickHouse: функция numbers() создаст нужное количество строк, а rand() заполнит поля псевдослучайными значениями.
INSERT INTO shop.events
SELECT
    d,
    toDateTime(d) + rand(3) % 86400,
    rand(4) % 500000,
    ['view', 'click', 'add_to_cart', 'purchase'][(rand(5) % 4) + 1],
    ['RU', 'KZ', 'BY', 'AM', 'UZ', 'GE'][(rand(6) % 6) + 1],
    round((rand(7) % 3000000) / 100, 2)
FROM
(
    SELECT toDate('2025-01-01') + (number % 365) AS d
    FROM numbers(20000000)
);
В результате получаем 20 миллионов событий за 2025 год для 500 тысяч пользователей. Именно эту базу мы будем использовать во всех следующих примерах.
Как устроено колоночное хранение
В строковых СУБД значения одной записи хранятся рядом. ClickHouse хранит данные по столбцам. Это значит, что значения event_date находятся вместе, значения country — отдельно, значения revenue — отдельно и так далее.
У такого подхода есть два важных преимущества. Во-первых, запрос читает только те столбцы, которые ему действительно нужны. Если в таблице 100 столбцов, а для расчёта нужны только три, то ClickHouse не нужно загружать остальные 97.
Во-вторых, данные внутри одного столбца хорошо сжимаются. В них находятся значения одного типа, часто похожие или повторяющиеся: даты, страны, статусы, категории. Алгоритмам сжатия гораздо проще работать с такими последовательностями, чем с перемешанными значениями разных типов.
Посмотрим, как это работает на нашей тестовой таблице. ClickHouse хранит статистику о размере столбцов в системной таблице system.columns. Нас интересуют два показателя: data_uncompressed_bytes показывает объём данных до сжатия, а data_compressed_bytes — сколько места они занимают после сжатия на диске.
Запустим функцию formatReadableSize(), которая переведёт байты в читаемые мегабайты, и поделим одно значение на другое, чтобы узнать коэффициент сжатия:
SELECT
    name AS column,
    type,
    formatReadableSize(sum(data_uncompressed_bytes)) AS uncompressed,
    formatReadableSize(sum(data_compressed_bytes))   AS compressed,
    round(sum(data_uncompressed_bytes) / sum(data_compressed_bytes), 1) AS ratio
FROM system.columns
WHERE database = 'shop' AND table = 'events'
GROUP BY name, type
ORDER BY ratio DESC;
Вот какие данные мы получили для нашей таблицы.
| Колонка | Тип | Без сжатия | На диске | Во сколько раз меньше |
|---|---|---|---|---|
| event_date | Date | 23,50 МиБ | 111,06 КиБ | 216,7 |
| country | LowCardinality(String) | 11,77 МиБ | 88,16 КиБ | 136,7 |
| event | LowCardinality(String) | 11,77 МиБ | 6,81 МиБ | 1,7 |
| revenue | Decimal(10, 2) | 93,99 МиБ | 57,27 МиБ | 1,6 |
| event_time | DateTime | 47,00 МиБ | 46,73 МиБ | 1,0 |
| user_id | UInt32 | 47,00 МиБ | 47,18 МиБ | 1,0 |
| Вся таблица | 235,03 МиБ | 158,18 МиБ | 1,49 |
Общий коэффициент сжатия можно получить отдельным запросом:
SELECT
    formatReadableSize(sum(data_uncompressed_bytes)) AS uncompressed,
    formatReadableSize(sum(data_compressed_bytes))   AS compressed,
    round(sum(data_uncompressed_bytes) / sum(data_compressed_bytes), 2) AS ratio
FROM system.columns
WHERE database = 'shop' AND table = 'events';
Разброс между столбцами получился большим. Лучше всего сжались event_date и country. Наша таблица отсортирована сначала по дате, а затем по стране, поэтому одинаковые и близкие значения часто оказываются рядом — это сильно помогает алгоритмам сжатия.
А вот user_id и event_time почти не сжались. Мы заполнили их псевдослучайными значениями, поэтому в данных почти нет повторяющейся структуры, которой мог бы воспользоваться алгоритм.
Из-за этого общий результат нашего синтетического теста довольно скромный — таблица уменьшилась примерно в 1,5 раза. На реальных наборах данных эффект может быть заметно сильнее.
Отдельно стоит учитывать LowCardinality (String). Этот тип сам по себе оптимизирует хранение строк с небольшим количеством уникальных значений. ClickHouse создаёт словарь значений и вместо самих строк хранит ссылки на него. Поэтому показатели data_uncompressed_bytes для таких столбцов нельзя напрямую воспринимать как размер тех же данных в обычном String.
Архитектура: движки, парты и ключ сортировки
В ClickHouse каждая таблица использует определённый движок. Он задаёт, как СУБД хранит данные, обрабатывает вставки, объединяет части таблицы и работает с дубликатами. Для большинства аналитических задач используют движки семейства MergeTree.
Данные в MergeTree хранятся отдельными частями — партами. Когда ClickHouse получает новую порцию данных, он создаёт один или несколько новых партов. Внутри каждого из них строки уже отсортированы по ключу таблицы, разбиты по столбцам, сжаты и записаны на диск.
Со временем таких частей становится много, поэтому ClickHouse в фоне объединяет небольшие парты в более крупные. Этот процесс называется слиянием, или merge, — отсюда и название семейства MergeTree.
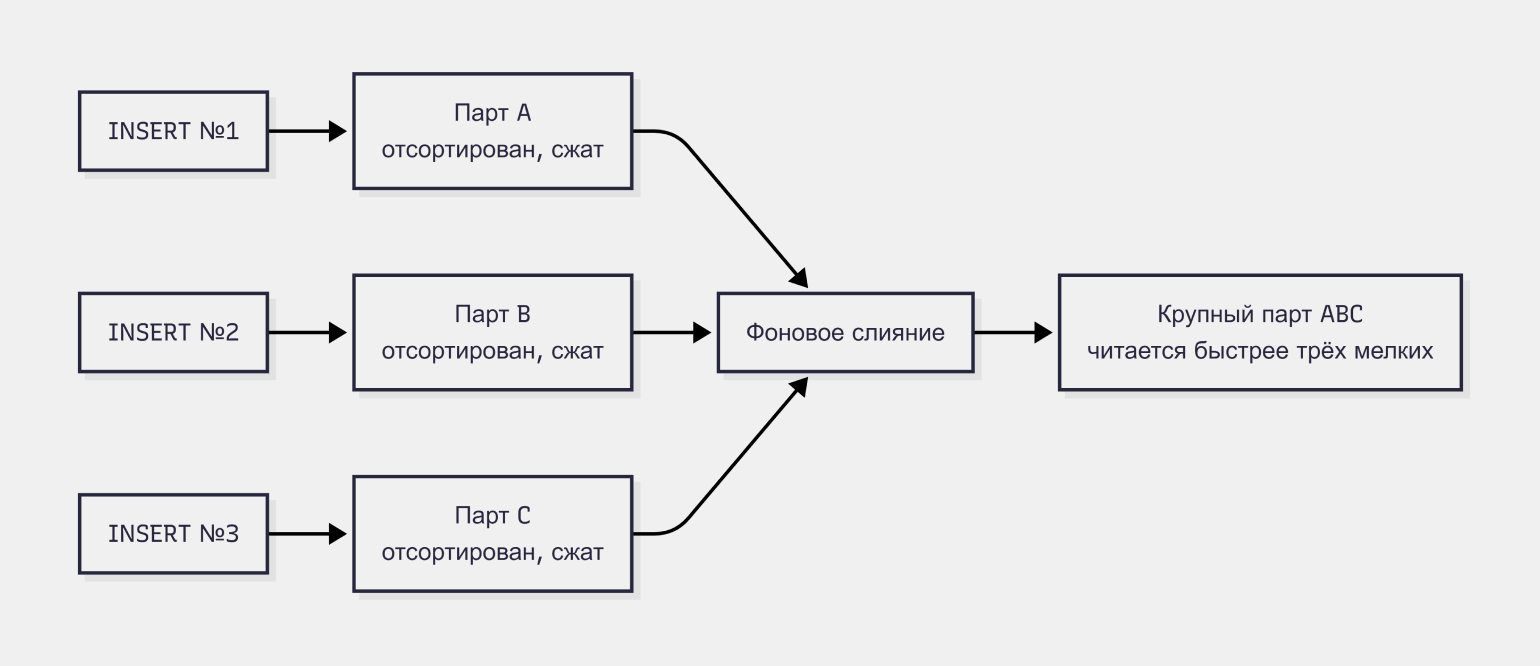
Изображение: Mermaid.ai / Skillbox Media
Из этой архитектуры следует важное правило: данные в ClickHouse лучше записывать крупными пачками. Если постоянно отправлять отдельные строки небольшими INSERT, таблица быстро обрастёт множеством мелких партов. ClickHouse придётся постоянно объединять их в фоне, а на это расходуются процессорное время, память и операции с диском.
Поэтому вместо тысячи вставок по одной строке лучше по возможности отправить одну вставку с тысячей строк.
При создании таблицы важны три параметра:
- ORDER BY — задаёт порядок сортировки внутри партов. От него сильнее всего зависит и скорость запросов, и степень сжатия. Ставьте в начало ключа те колонки, по которым чаще всего фильтруете.
- PARTITION BY — делит данные на логические куски, обычно по месяцам. Партиции удобно удалять целиком, и они помогают отсекать данные на старте запроса.
- PRIMARY KEY — индекс, с помощью которого движок понимает, какие блоки можно пропустить. По умолчанию совпадает с ORDER BY.
В кластере ClickHouse раскидывает данные по нескольким серверам и реплицирует их. За координацию реплик отвечает ClickHouse Keeper.
ClickHouse на практике: считаем метрики интернет-магазина
Таблица shop.events у нас уже есть — на ней мы проверяли сжатие, колоночное чтение и работу ключа сортировки. Теперь посмотрим, как ClickHouse решает более прикладную задачу: посчитаем показатели интернет-магазина и подготовим витрину для дашборда.
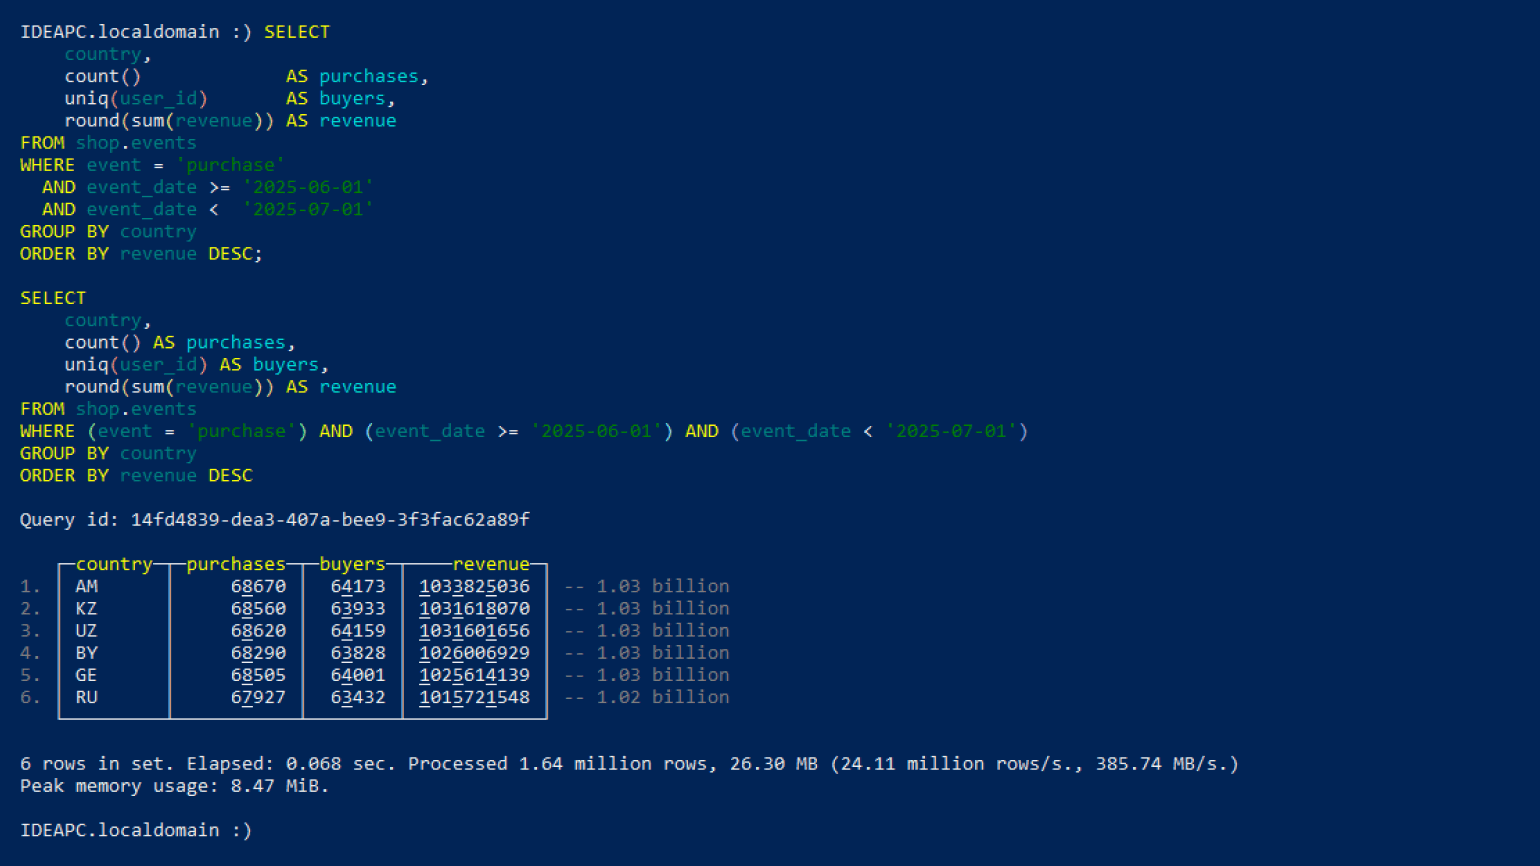
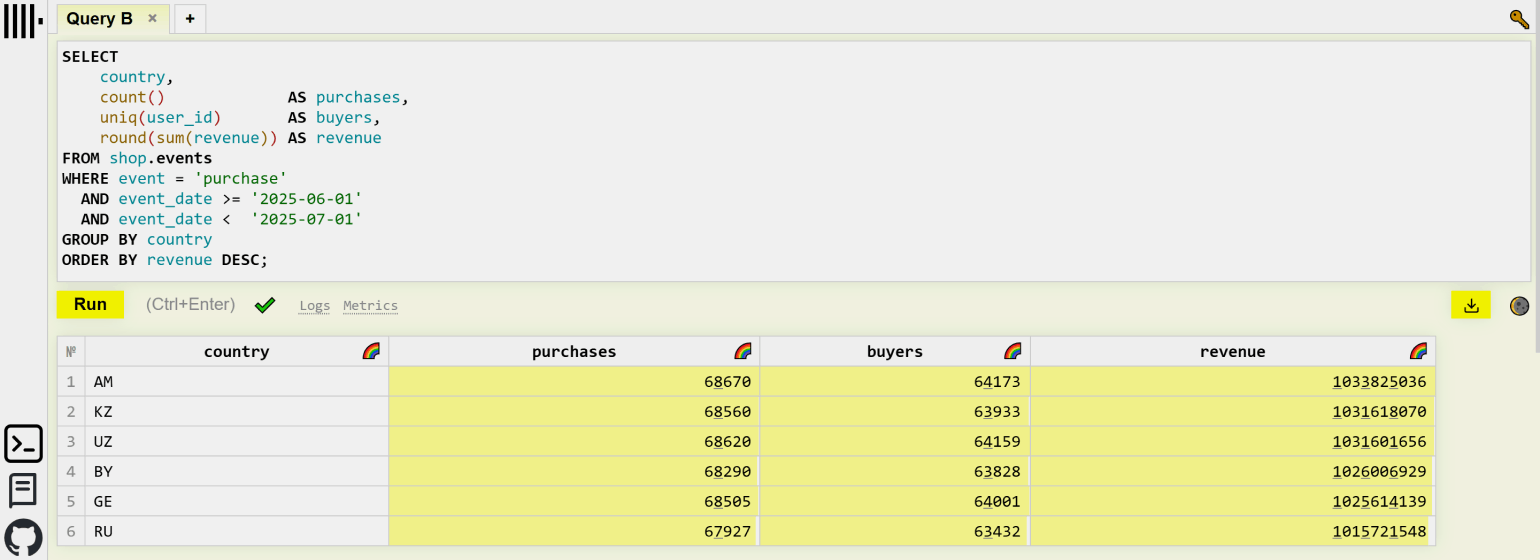
Начнём с отчёта по продажам за июнь 2025 года. Для каждой страны посчитаем количество покупок, число покупателей и общую выручку:
SELECT
    country,
    count()            AS purchases,
    uniq(user_id)      AS buyers,
    round(sum(revenue)) AS revenue
FROM shop.events
WHERE event = 'purchase'
  AND event_date >= '2025-06-01'
  AND event_date <  '2025-07-01'
GROUP BY country
ORDER BY revenue DESC;
Функция uniq() приблизительно считает количество уникальных значений. Для аналитических задач такой оценки часто достаточно, а если требуется точный результат, можно использовать uniqExact().
На нашем стенде запрос обработал 1,64 миллиона строк и 26,30 МБ данных, выполнился за 0,068 секунды и использовал 8,47 МиБ памяти. Эти показатели clickhouse-client выводит после выполнения запроса.
Для разового отчёта этого достаточно. Но представим, что те же показатели постоянно запрашивает дашборд. Каждый раз пересчитывать их по миллионам исходных событий необязательно — часть работы можно выполнить заранее.
Для этого в ClickHouse используют материализованные представления. Инкрементальное материализованное представление работает примерно как обработчик вставки: когда в исходную таблицу приходит новая порция строк, ClickHouse выполняет над ней заданный запрос и записывает результат в другую таблицу.
Создадим небольшую витрину с количеством покупок и выручкой по странам за каждый день:
CREATE TABLE shop.daily_country
(
    event_date Date,
    country    LowCardinality(String),
    purchases  UInt64,
    revenue    Decimal(38, 2)
)
ENGINE = SummingMergeTree
ORDER BY (event_date, country);

CREATE MATERIALIZED VIEW shop.mv_daily TO shop.daily_country AS
SELECT
    event_date,
    country,
    count()      AS purchases,
    sum(revenue) AS revenue
FROM shop.events
WHERE event = 'purchase'
GROUP BY event_date, country;
Теперь вместо исходных событий дашборд может обращаться к значительно меньшей таблице. Например, июньский отчёт строится так:
SELECT
    country,
    sum(purchases) AS purchases,
    sum(revenue) AS revenue
FROM shop.daily_country
WHERE event_date >= '2025-06-01'
    AND event_date < '2025-07-01'
GROUP BY country
ORDER BY revenue DESC;
Здесь снова используем sum(), хотя данные уже агрегированы. Дело в том, что SummingMergeTree объединяет строки с одинаковым ключом во время фоновых слияний. До очередного слияния агрегаты за одну дату и страну могут физически находиться в нескольких строках, поэтому при чтении их нужно суммировать.
В результате дашборд работает уже не с миллионами событий, а с компактной таблицей дневных агрегатов. При этом исходные данные остаются в shop.events. По ним можно строить другие отчёты или при необходимости заново рассчитать витрину.
Такой подход переносит часть вычислений с момента чтения на момент записи. Чем чаще выполняется один и тот же тяжёлый аналитический запрос, тем больше пользы может дать заранее подготовленная витрина.
Скриншот: ClickHouse / Skillbox Media
Где применяют ClickHouse
ClickHouse используют там, где данных много, они в основном дописываются, а не изменяются, и по ним регулярно считают агрегаты. Чаще всего встречаются такие сценарии:
- Продуктовая и веб-аналитика. ClickHouse используют для обработки больших потоков событий: просмотров страниц, кликов, регистраций, покупок и других действий пользователей. На этих данных считают воронки, удержание, активность, когорты и другие продуктовые метрики.
- Логи и наблюдаемость. В ClickHouse можно складывать логи приложений, серверов и инфраструктуры, а затем искать ошибки, всплески задержек и аномальное поведение сервисов. Такой сценарий особенно удобен, когда нужно быстро анализировать события сразу по всему стеку за длительный период.
- Метрики приложений и инфраструктуры. ClickHouse подходит для хранения и анализа временных рядов: загрузки CPU, использования памяти, сетевой активности, времени ответа и других показателей. На их основе считают процентили, отслеживают динамику и сравнивают состояние системы между разными периодами.
- Финансовая аналитика и антифрод. СУБД используют для анализа больших потоков операций и поиска нетипичного поведения. Например, можно искать резкие отклонения от обычных трат, необычные сочетания параметров транзакций или всплески активности по отдельным сегментам пользователей.
- Маркетинговая аналитика. ClickHouse помогает объединять данные из рекламных кабинетов, CRM, с сайта и других источников в одном хранилище. После этого можно считать стоимость привлечения, конверсии, атрибуцию и сравнивать эффективность кампаний, каналов и аудиторных сегментов.
Во всех этих сценариях ClickHouse решает одну и ту же задачу — быстро обрабатывать большие объёмы событий и находить в них нужные закономерности. Чем больше данных накапливается и чем чаще по ним нужно строить отчёты, срезы и агрегаты, тем заметнее преимущества такой архитектуры.
Плюсы и минусы ClickHouse
ClickHouse очень хороша в тех задачах, для которых её проектировали: хранить большие объёмы данных и быстро выполнять по ним аналитические запросы. Но специализация накладывает ограничения — использовать эту СУБД как универсальную замену PostgreSQL или MySQL обычно не стоит.
Плюсы ClickHouse:
- Высокая скорость аналитических запросов. Колоночное хранение, сжатие, векторизованное выполнение и разреженные индексы позволяют быстро агрегировать миллионы и миллиарды строк.
- Эффективное хранение данных. Значения одного столбца часто хорошо сжимаются, поэтому большие таблицы могут занимать заметно меньше места на диске. Заодно уменьшается объём данных, который приходится читать при выполнении запросов.
- Работа с большими объёмами. ClickHouse рассчитана на таблицы с миллиардами строк и большие потоки новых событий. При необходимости нагрузку можно распределять между несколькими серверами с помощью шардирования и репликации.
- Знакомый SQL. Для работы используется SQL, поэтому разработчику, который уже знаком с PostgreSQL, MySQL или другой реляционной СУБД, не приходится изучать совершенно новый язык запросов. При этом у ClickHouse есть собственные функции и особенности диалекта.
- Открытый исходный код. ClickHouse распространяется под лицензией Apache 2.0. Её можно самостоятельно развернуть на своих серверах или использовать готовый управляемый сервис в облаке.
Минусы ClickHouse:
- Не подходит на роль классической OLTP-базы. ClickHouse создавалась прежде всего для аналитики, а не для корзин интернет-магазинов, банковских транзакций и других сценариев, где постоянно читают и изменяют отдельные записи.
- SQL ведёт себя не везде привычно. Хотя ClickHouse поддерживает SQL, некоторые конструкции и принципы работы отличаются от PostgreSQL и MySQL. Особенно это касается транзакций, обновлений, индексов, ограничений целостности и движков таблиц.
- Кластеры усложняют эксплуатацию. Один сервер ClickHouse поднять сравнительно просто, но крупная распределённая система с шардами, репликами и ClickHouse Keeper требует отдельных знаний в мониторинге, настройке и восстановлении после сбоев.
- Для небольших проектов может быть избыточным. Если данных немного, а аналитические запросы выполняются редко, отдельная ClickHouse добавит ещё одну систему, которую придётся разворачивать, обновлять и поддерживать. В таких случаях возможностей PostgreSQL или другой уже используемой СУБД может быть достаточно.
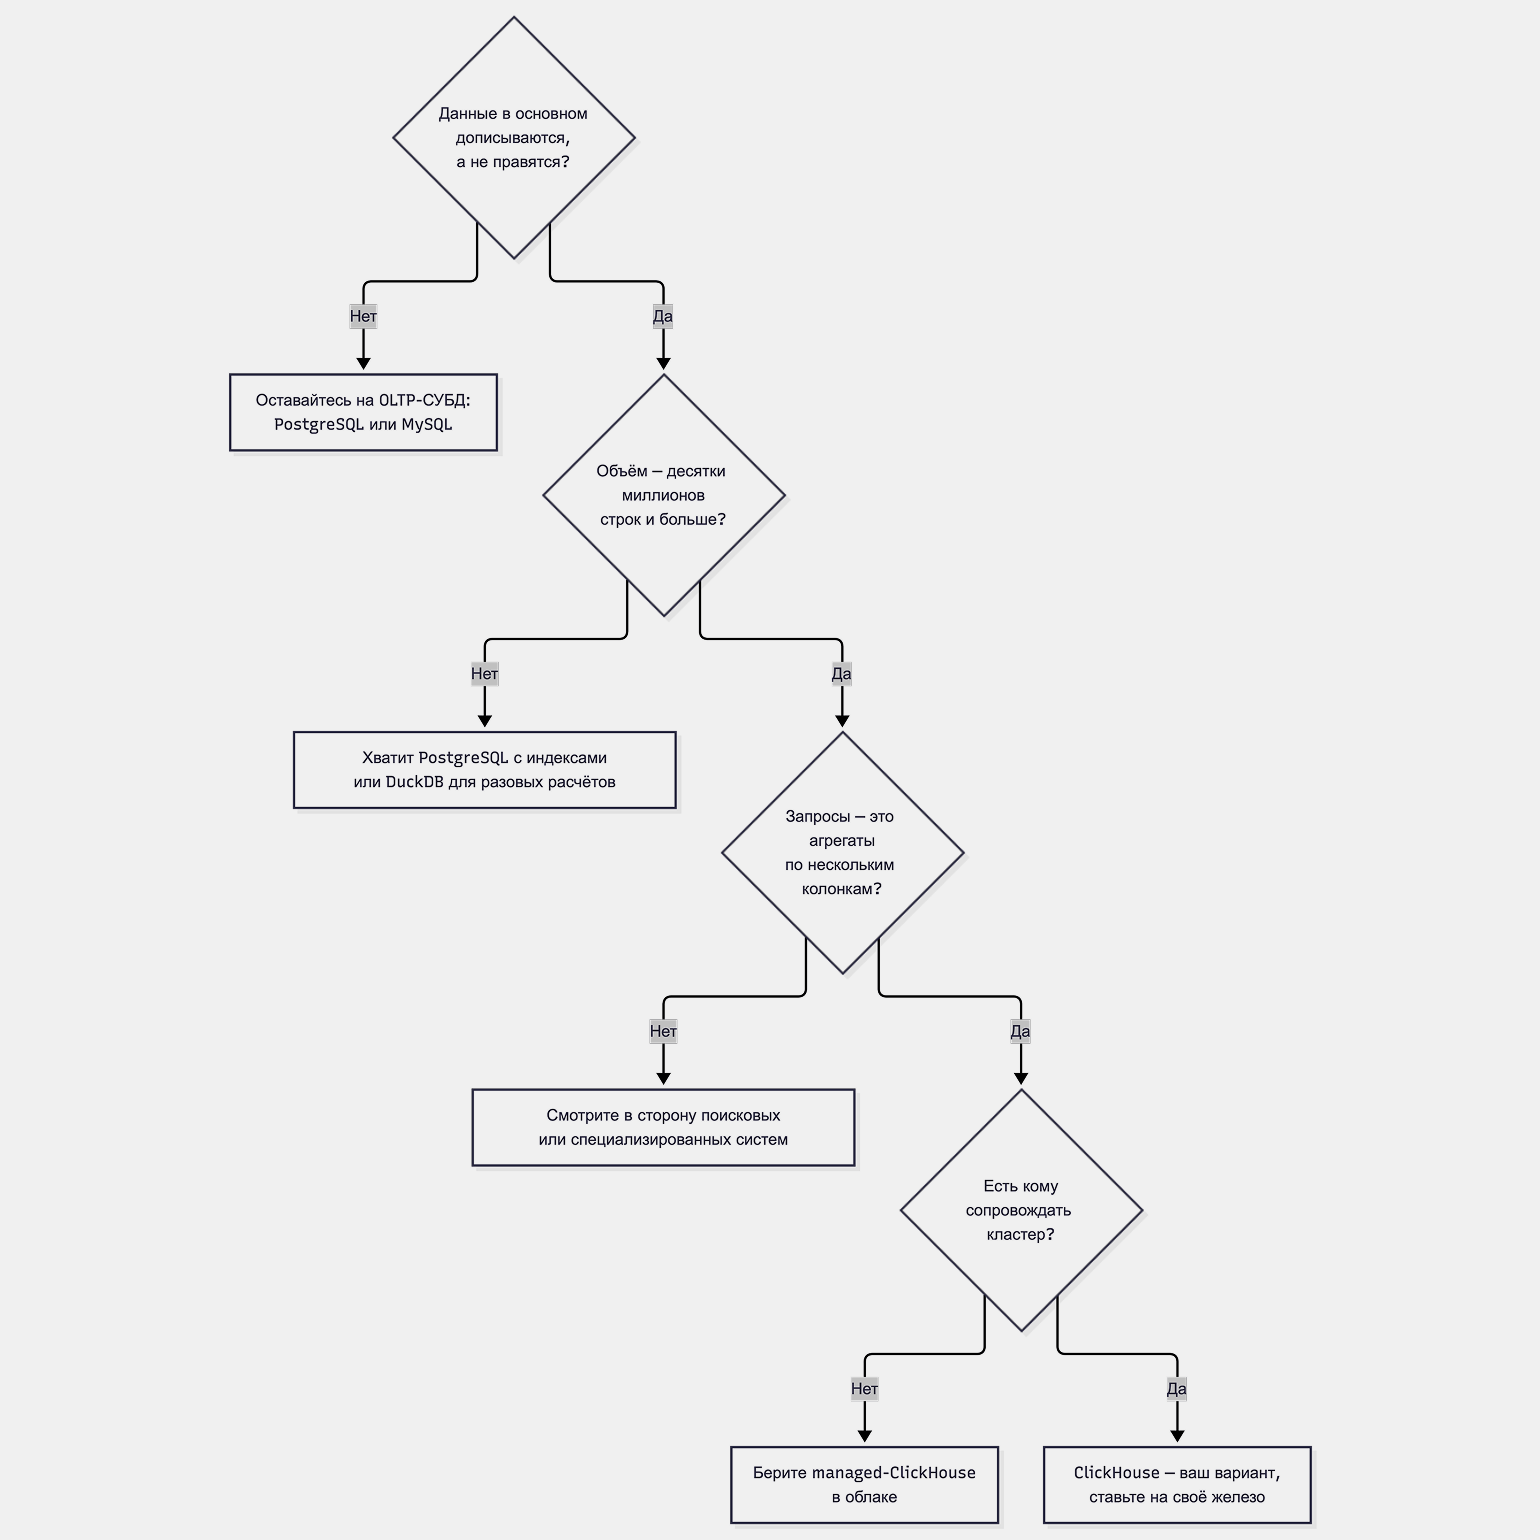
В итоге ClickHouse стоит выбирать, когда профиль задачи совпадает с архитектурой СУБД. Если данные поступают большими потоками, редко изменяются после записи и по ним постоянно считают агрегаты, то ClickHouse может стать хорошим решением.
Мы составили блок-схему, с которой проще решить, стоит ли использовать в проекте ClickHouse. Просто отвечайте на вопросы и смотрите, куда вас приведут ответы.
ClickHouse против конкурентов
У ClickHouse нет одного прямого конкурента. В разных сценариях она пересекается с транзакционными СУБД, классическими хранилищами данных, облачными аналитическими платформами и поисковыми движками. Поэтому сравнивать их лучше по конкретным задачам.
| Система | В чём сильнее ClickHouse | В чём сильнее конкурент |
|---|---|---|
| PostgreSQL | Массовые агрегации по большим таблицам, работа с потоками событий, сжатие | Транзакции, точечные операции, ограничения целостности, развитая экосистема расширений |
| MySQL | Аналитические запросы, обработка событий и логов | CRUD-приложения, частые изменения отдельных записей, привычная модель для веб-разработки |
| Greenplum | Быстрые запросы по большим денормализованным таблицам, относительно простое развёртывание одного узла | Классические DWH-схемы, сложная реляционная аналитика и большое количество JOIN |
| DuckDB | Серверная работа под постоянной нагрузкой, репликация, кластеры и непрерывная загрузка данных | Локальный анализ файлов без отдельного сервера, встраивание в приложения и скрипты |
| Snowflake, BigQuery | Возможность работать на собственном железе, полный контроль над инфраструктурой и расходами | Полностью управляемая инфраструктура и автоматическое масштабирование вычислительных ресурсов |
| Elasticsearch | Агрегации по большим объёмам логов, эффективное хранение и сжатие | Полнотекстовый поиск, анализ текста, релевантность и ранжирование результатов |
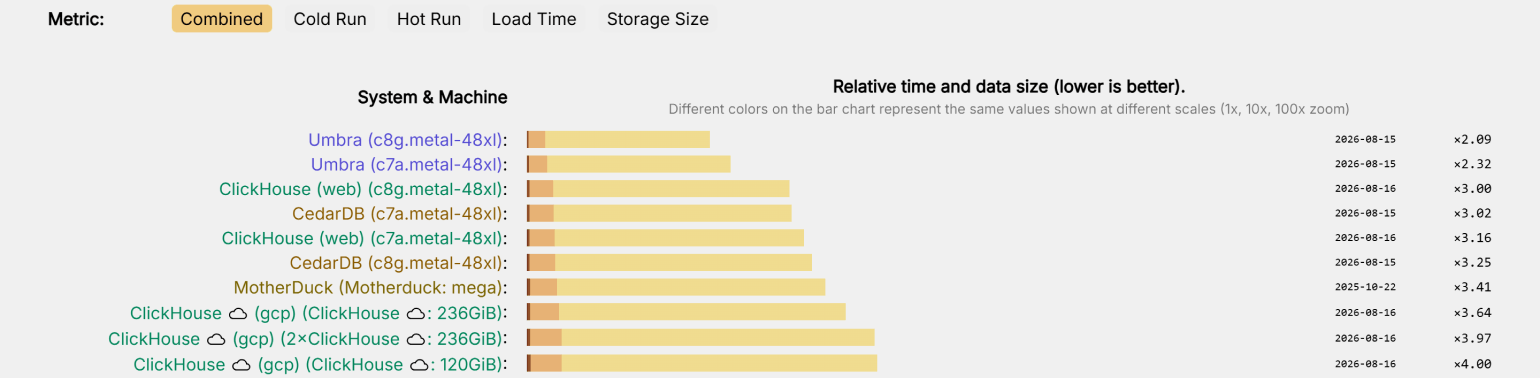
Оценить скорость работы ClickHouse можно в официальном бенчмарке ClickBench. Для анализа нём используют одну таблицу примерно на 100 миллионов строк, полученных из реальных данных веб-аналитики, и набор из 43 запросов. Они проверяют полное и отфильтрованное сканирование данных, агрегации, работу со строками, индексами и другие типичные аналитические операции.
Скриншот: Benchmark / Skillbox Media
Больше интересного про код — в нашем телеграм-канале. Подписывайтесь!